
2026年9月14日,北京大学全国医学教育发展中心江哲涵团队在《npj Digital Medicine》在线发表研究论文“Multi-Agent collaboration as a complementary architecture for AI-generated medical examination items”。研究基于AI多智能体架构,根据高利害命题过程中的角色与分工设定不同智能体,通过面向命题专家的盲评实证设计,验证该框架在生成式试题质量强化方面的可行性与实用性。
图1:论文截图
现有AI辅助医学考试题目生成研究主要依赖单一模型一次性生成,难以兼顾事实准确性、临床合理性与命题规范性,尤其在高阶推理题目上质量瓶颈明显。本研究由此提出一个关键问题:能否将人类高利害考试命题中“起草—独立评审—编辑综合—迭代修订”的多角色协作流程,转化为多智能体架构,从而突破单模型生成的质量上限?
针对上述问题,该研究开发了开源多智能体框架MAID(Multi-Agent Item Development),将题目开发分解为1个作者智能体、3个独立评审智能体(分别负责事实准确性、临床合理性与命题质量)、1个编辑智能体及可选的图像生成与验证智能体,并将多个LLM随机分配至各角色以避免单一模型的系统性偏差。
实验结果显示,多智能体协作带来显著的题目质量提升:在14名来自7个医学学科的专家参与的双盲配对评估中,多智能体生成的题目获得57.7%的专家偏好,显著高于单模型基线的42.3%(χ²(1)=8.33,p=0.004),且优势在全部7个学科中方向一致。此外,该框架支持多模态内容生成与语义一致性校验,完整代码已开源,便于跨专科适配与独立复现。
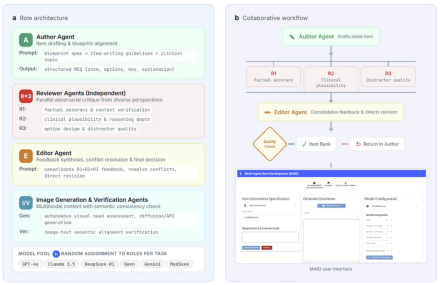
图2:MAID框架的角色分工与设定流程
北京大学全国医学教育发展中心长聘副教授、研究员江哲涵为论文第一作者及通讯作者。该研究得到国家自然科学基金和英国上市公司365相关项目支持。
文章链接:https://www.nature.com/articles/s41746-026-03187-z
代码链接:https://github.com/zjiang4/MAID